一句话:UNIQUE 不是用一个纯自回归模型直接替代全链路,而是用“单层 code 分类召回 + target-aware 多任务排序”的混合架构,把生成式召回和传统判别式排序放进同一个早期融合模型。
1. 先回答核心问题
生成式推荐讲了几年,大家最关心的问题其实很朴素:它能不能真正进入工业系统,在有限延迟内同时做好召回和排序?
RecSys 2026 的这篇 UNIQUE: A Unified Retrieval and Ranking System for Large-Scale Feed Recommendation 来自百度,部署在手机百度首页 Feed、发现页和短视频推荐场景。论文给出的答案不是“完全生成式化”,而是一个更工程化的折中:用一层扁平 semantic code 表示 item 所属语义簇,用早期融合 Transformer 同时处理用户历史、候选 code 和候选 item,再用多任务 heads 输出相关性、CTR、观看时长、完播等目标。
线上一周全量 A/B 测试中,总观看时长提升 0.96%,总分发量提升 1.08%,用户留存提升 0.70%;服务侧 P99 延迟为 89ms,在线推理 MFU 为 44.23%。
2. 传统级联卡在哪里
工业推荐系统通常采用“召回 → 粗排 → 精排”的级联。这个架构很稳:召回负责从大库里找候选,排序负责读更多特征、做更复杂的交叉和多目标预估。但它也有两个长期问题。
问题一:层级量化不稳定
TIGER 一类生成式检索方法通常使用 RQ-VAE,把 item 编成多层 residual code。前一层的量化误差会继续影响后层,而且 code 使用可能集中在少数热门码字上,导致头部 code 过载、长尾 item 表达不足。
另一个问题是,很多 tokenizer 主要依赖标题、类目、作者等 item 先验。这样学出来的 code 更像内容聚类,但推荐系统真正需要的,是用户反馈约束下的兴趣空间。
问题二:召回和排序割裂
召回模型和排序模型通常分别训练,使用的表征、目标和特征深度都不一样。召回输出的候选进入排序模型后,很多用户与候选之间的细粒度关系需要重新计算,跨阶段传递会损失信息。
论文也指出,HSTU 等工作证明了生成式序列模型的缩放潜力,但召回和排序仍相对独立;而纯生成式统一框架又缺少传统判别式排序的精细建模能力。
3. UNIQUE 怎么统一
UNIQUE 由三个核心模块组成:
| 模块 | 全称 | 作用 |
|---|---|---|
| EQN | End-to-End Quantization Network | 学习 item 的反馈感知向量,并通过单层扁平码本分配 code |
| UIGN | User Interest Generation Network | 编码用户画像、短期、中期和长期兴趣序列 |
| TDN | Target-Code-Aware Discriminative Network | 把候选 item/code 注入用户历史,完成多任务精细排序 |
整体架构如下图所示:
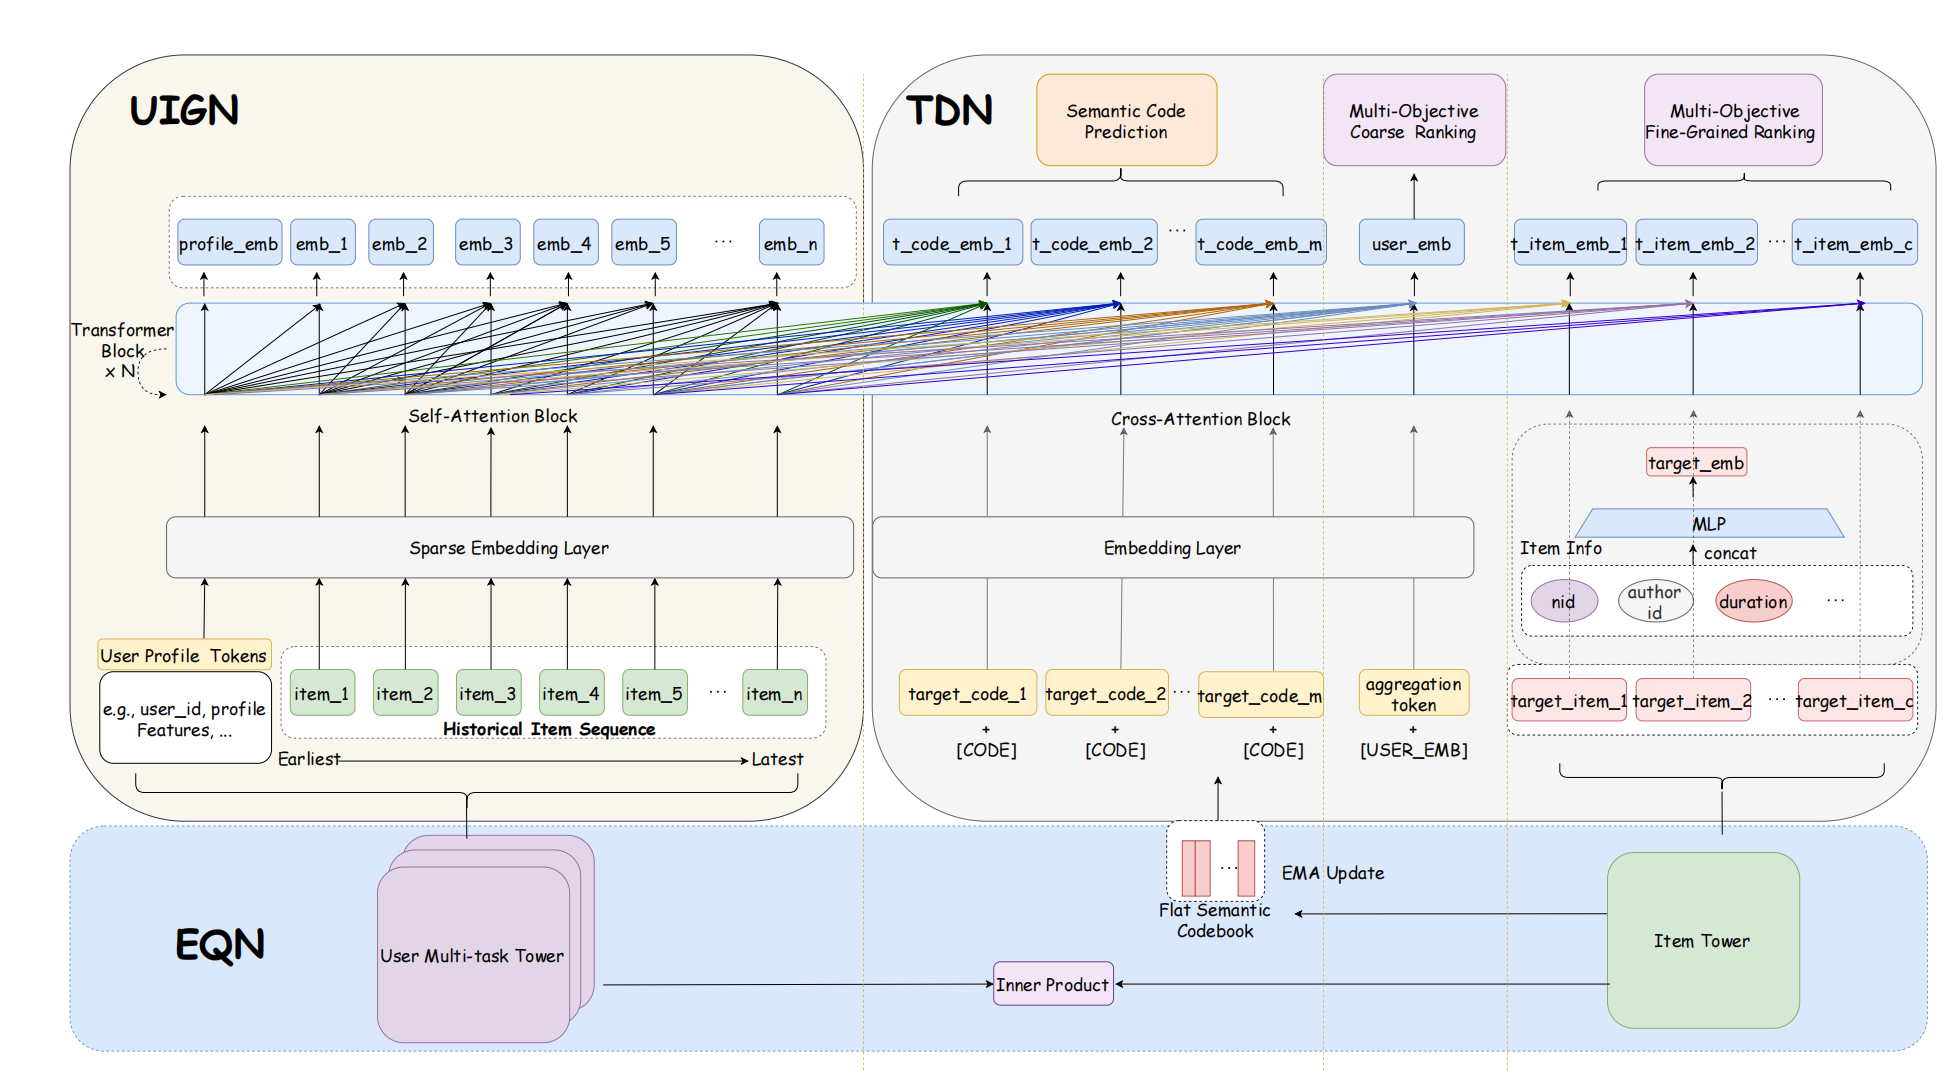
这里的关键是 target-attention split。用户历史内部可以做 self-attention;候选 item 和候选 code 作为 target,只允许它们关注用户前缀,不允许 target 之间互相 attention。这样既能让每个候选直接读取相关历史行为,也避免大量候选互相干扰。
4. 损失到底怎么拆
这篇论文最容易被名字绕住的地方,是“生成式”到底指什么。由于 UNIQUE 只有一级码本,召回分支没有多层 SID 的逐 token 自回归生成,也没有跨多个 token position 的 beam search。它在数学上更接近一个 next-code 分类任务。
假设用户下一个正反馈 item 是 ,它离线被分配到的 code 是 。模型对所有 code 计算 logits,并在 个 code 上做 softmax:
所以生成式损失就是普通交叉熵:
线上取 top 个 code,本质上是取这个分类器的 top-100 类别,而不是生成 100 条多 token SID 序列。这个 code 代表一个语义区域或候选簇,多个 item 可以共享同一个 code。
Item 排序分支则更像传统的 target-aware 排序塔。候选 item token 与用户历史交互后,得到用户条件化表示:
之后接多个任务 heads:
二值目标使用加权 BCE,时长目标使用 MSE:
需要注意的是,CTR、CVR 和 next-item prediction 的标签语义不同。CTR 是曝光后是否点击,CVR 通常是点击后是否转化,next-item prediction 是下一时刻是否交互。论文没有明确给出 CVR 目标,因此更准确的说法是:TDN 是一个候选感知的多任务 pointwise ranking network,而不是简单等同 CTR/CVR 塔。
DSSM 监督在哪里
论文中的 DSSM 监督确实存在,形式是 task-specific user tower 与共享 item tower 的内积:
但它的主要作用是训练码本构建用的 item tower,让 item 向量在量化前吸收用户反馈后验。它不是最终 serving 时必须计算的损失。工程上更清晰的拆法是:
阶段 A:离线构建码本
  使用 L_code + L_quant 训练 DSSM user/item towers
  得到 item embedding z_i
  做 balanced flat quantization,生成 c_i
  冻结或周期性刷新码本

阶段 B:训练统一召回排序主模型
  L_main = L_disc + alpha L_gen
因此,论文总公式虽然写成:
但从工程实现看,可以拆成两个阶段: 和 服务于离线码本构建, 和 服务于主模型的召回与排序。
5. 线上怎么解码和服务
在线推理时,UNIQUE 先预测 semantic code 分布,取 top code,再通过 code-to-item 索引展开候选。论文使用两个关键参数控制探索和利用:
- :选择 100 个 code,控制跨语义区域的探索。
- :每个 code 下保留 30 个 item,控制 code 内的利用。
用户前缀编码
  -> 预测 semantic code 分布
  -> 取 top 100 个 code
  -> code-to-item 按新鲜度、热度、可用性展开
  -> 粗排保留 top 10k
  -> 按 code 分组进入精细 TDN
  -> 每 code 保留 30 个 item
  -> 融合相关性、CTR、时长、完播等分数
论文的敏感性分析显示, 只带来边际多样性提升,但成本接近翻倍; 则会明显伤害召回。因此 是质量和成本之间的平衡点。
生产码本使用 16,384 个单层 code,替代总容量相同的 128×128 层级码本。单层码本使资源计数方差从 1510.85 降到 389.57,同时平均 top-1 category share 从 65.43% 提升到 78.08%。这说明它不只是把样本摊匀,也提高了 cluster 的类目纯度。
服务系统在高峰期约处理 10,000 QPS,运行在约 400 张 NVIDIA L20 GPU 上,使用 TensorRT FP16。新内容首次曝光后 5 分钟内进入训练流,1 小时内完成量化。
6. 我的判断
UNIQUE 的价值,不在于提出了一个数学上多复杂的新生成模型,而在于给出了一个更容易落地的工业架构:生成 code 负责全库覆盖、语义泛化和长尾探索;判别排序负责 item 级精度和多目标预估;二者共享早期融合表示。
这也提醒我们,做生成式推荐不必一开始就追求“一个自回归模型替代全链路”。在真实系统里,更稳的路径可能是先把召回空间 code 化,再把 target-aware 排序和 code 召回放到共享表示中联合训练。
我会把 UNIQUE 看成一条中间路线:它保留了生成式检索的框架和语义优势,也保留了传统推荐系统最擅长的候选感知排序。对于想在现有级联系统中渐进引入 GR 的团队,这篇论文的参考价值很高。